LLMを導入したのに、使い道が見つからない理由
木村 優志
先日、大手企業でLLMを導入したものの、どう活用すればよいか分からず、その支援を求めているという仕事の募集を見かけました。
その募集だけで、社内の事情までは分かりません。ただ、LLMを導入して社員へチャット画面を提供するだけでは、こうした悩みが生まれるのも自然だと思います。
文章を書いたり、考えを整理したり、一般的な知識を尋ねたりする用途はあります。しかし、会社の仕事を進めるために必要な情報は、受注管理、在庫管理、顧客管理などの社内システムにあります。仕事の結果を残す場所も、それらのシステムです。
LLMを質問応答の道具として使うだけでは、その能力を業務へ十分に生かせません。社内システムにつなぎ、情報の取得から処理、結果の反映までを設計する必要があります。
チャットの前後に、人の作業が残っている
たとえば、営業担当者が「A社の未出荷注文を確認して、納期の問い合わせへの返信案を作りたい」と考えたとします。
LLMが社内システムにつながっていなければ、担当者は受注管理でA社を探し、未出荷の注文を確認し、在庫や出荷予定を調べます。必要な情報をチャットへ貼り付け、返信案を作ってもらい、内容を確認してメールへ移します。対応履歴も別途登録します。
LLMは文章を作る部分を助けていますが、情報を探し、取り出し、別の場所へ移す作業は人が行っています。プロンプトを工夫しても、接続されていないシステムの現在の出荷予定を取得することはできません。
社員に「もっとLLMを活用してください」と伝えても、この作業の構造は変わりません。むしろ、入力する情報を準備する手間が大きければ、自分で返信を書いた方が早いと感じるでしょう。
社内システムにつなぐと、依頼できる仕事が変わる
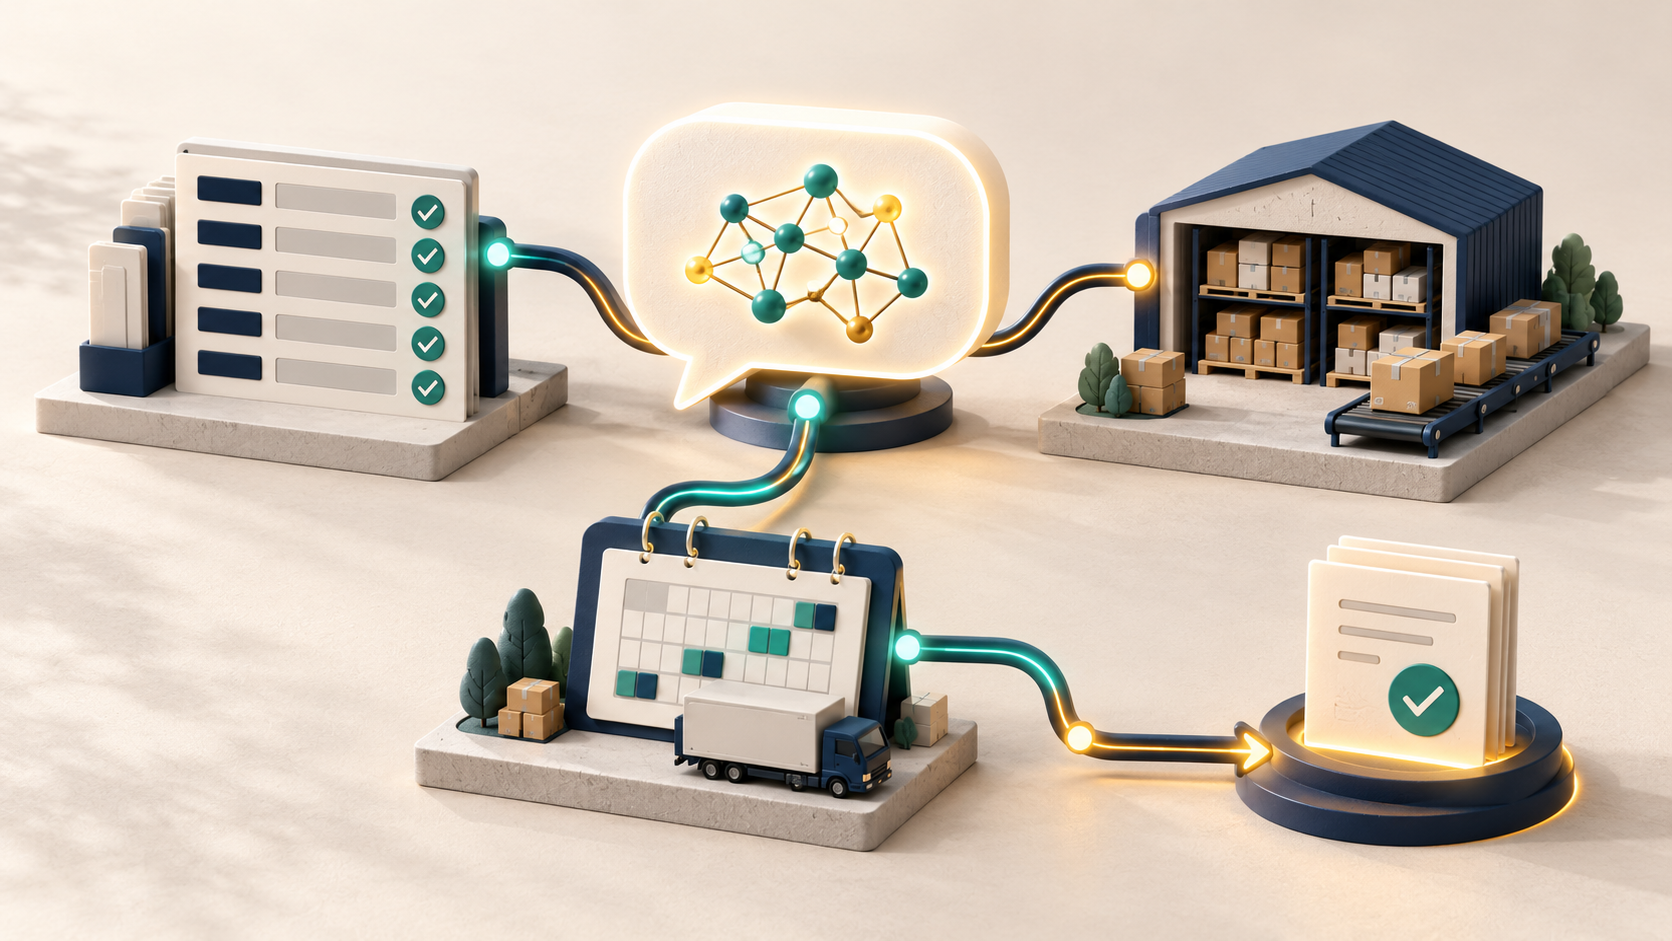
同じ依頼でも、LLMが必要な情報を取得するツールを使えれば、処理を次のように組み立てられます。
「A社の未出荷注文を確認して、納期の返信案を作って」
  → 顧客を特定する
  → 未出荷の注文を取得する
  → 各注文の出荷予定を取得する
  → 確認できた情報から返信案を作る
  → 担当者が確認・送信する
  → 対応履歴を登録する
ここでLLMが担うのは、文章の生成に加え、依頼内容を解釈し、必要な情報を選び、取得結果を組み合わせることです。人が画面を行き来しながら行っていた仕事の一部を、システムとの接続によって扱えるようになります。
この場合、最初の導入範囲は、返信案を作るところまででも構いません。送信や履歴登録まで進めるなら、それぞれに接続と実行条件を用意します。情報を読めるようにしただけで、更新もできるようになるわけではありません。
また、社内規程や製品マニュアルを検索するRAGも有効ですが、文書を検索する仕組みと、現在の受注状況や出荷予定を照会する仕組みは役割が違います。業務によっては、文書検索とシステムへの問い合わせを組み合わせる必要があります。
APIをつなぐだけでは、業務の意味は伝わらない
実装では、Function Callingなどを使って、LLMから呼び出せる操作を用意します。先ほどの例なら、次のようなツールが考えられます。名前や引数は説明用の例です。
find_customer(name)
list_unshipped_orders(customer_id)
get_shipping_schedule(order_id)
LLMが選んだツールと引数をアプリケーションが検証し、社内APIを呼び出し、その結果をLLMへ返します。認証情報は接続側で管理し、権限の確認や入力の検証もそこで行います。
ただし、既存APIをそのまま公開すれば十分とは限りません。「未出荷」にキャンセル済みの注文を含めるのか。一部だけ出荷した注文はどう返すのか。出荷予定が未確定のとき、空欄とするのか、未確定という状態を返すのか。こうした定義によって、LLMが作る回答も変わります。
特に、出荷予定日と顧客への到着予定日は違います。取得した日付の意味が曖昧なら、LLMが出荷日を納品日として案内してしまうかもしれません。結果には、日付だけでなく、その種類、確定状況、更新日時など、判断に必要な情報を含めます。
顧客名に複数の候補があれば確認を求める。出荷予定を取得できなければ、その注文は確認が必要だと返す。LLMが推測で穴を埋めなくて済むように、業務上の意味と取得できなかった情報を、接続先から明確に返すことが大切です。
決まった処理まで、毎回LLMに考えさせる必要はない
社内システムとの接続というと、AIエージェントが自由にツールを選び、すべての仕事を進める構成を想像するかもしれません。
しかし、処理の順番が決まっている業務では、通常のプログラムで流れを組み、その一部にLLMを使えます。たとえば、未出荷注文と出荷予定の取得はコードで行い、問い合わせ文の意図の把握と返信案の作成にLLMを使う構成です。
金額計算や状態の判定も、既存の業務ロジックで処理できるなら、その結果を使います。LLMに同じルールを文章で説明し、毎回計算させる必要はありません。
Anthropicも、あらかじめ定義した処理経路に従うワークフローと、LLMが処理やツール利用を動的に選ぶエージェントを区別しています。業務の手順がどれだけ決まっているかに応じて、構成を選べます。参考:Building effective agents
既存システムが持つ確定的な処理と、LLMが扱える曖昧な言葉や文章を組み合わせる。この分担を考えることが、接続の設計になります。
一つの仕事が進むところまで作る
最初から全社のシステムをつなぐ必要はありません。「未出荷注文の問い合わせに対する返信案を作る」のように、一つの仕事を選び、必要なデータと操作をそろえます。
読み取りは利用者の権限に従い、送信や更新は内容を確認してから実行する。履歴登録を再試行したときに二重登録しない仕組みも、アプリケーション側で用意します。権限や更新の成否を、LLMへの指示だけで管理しないことが重要です。
効果を測るときも、自然な返信文ができたかだけでは足りません。必要な注文を漏れなく取得できたか、未確定の予定を確定した納期として伝えていないか、担当者の確認と修正を含めて作業時間が短くなったかまで確かめます。
LLMを導入したのに使い道が見つからないとき、社員が質問の仕方を知らないことだけが原因とは限りません。仕事に必要な情報へアクセスできず、作った結果を業務へ戻せない状態になっていないでしょうか。
私は、LLMの真価は、会社が持つ情報や処理へ接続したときに発揮されると考えています。受注情報を調べ、返信案を作り、確認した内容を履歴に残す。その一つの流れを作ることが、LLMを使える環境から、仕事で使える仕組みへ進むための開発です。